

Les applications de rencontre en ligne n’ont rien d’un jeu de hasard. Derrière chaque profil suggéré, chaque « match » et chaque message priorisé, un algorithme trie, classe et hiérarchise les utilisateurs selon des critères bien précis. Comprendre ces mécanismes offre un vrai levier pour reprendre la main sur son expérience amoureuse numérique.
Ce guide explore la logique des algorithmes de matching, la manière dont ils évaluent l’activité, les préférences et le comportement, ainsi que leurs limites. De quoi éclairer des questions que beaucoup se posent sans jamais obtenir de réponse transparente.
| Élément clé | Contenu essentiel |
|---|---|
| Objectif des algorithmes | Analyser comportements et préférences pour proposer des profils compatibles 💡 |
| Données utilisées | Centres d’intérêt, interactions, localisation, habitudes en ligne |
| Fonctionnement global | Croisement de données + modèles prédictifs pour identifier le « meilleur match » potentiel |
| Bénéfices pour l’utilisateur | Suggestions plus pertinentes, gain de temps, meilleure compréhension de ses propres préférences 👍 |
Poids des criteres dans les algorithmes de matching en ligne
Sources : donnees agregees a partir des publications techniques de Tinder, Bumble, Hinge et OkCupid (2022-2024).

Comprendre un algorithme de rencontre en ligne : la base pour mieux matcher
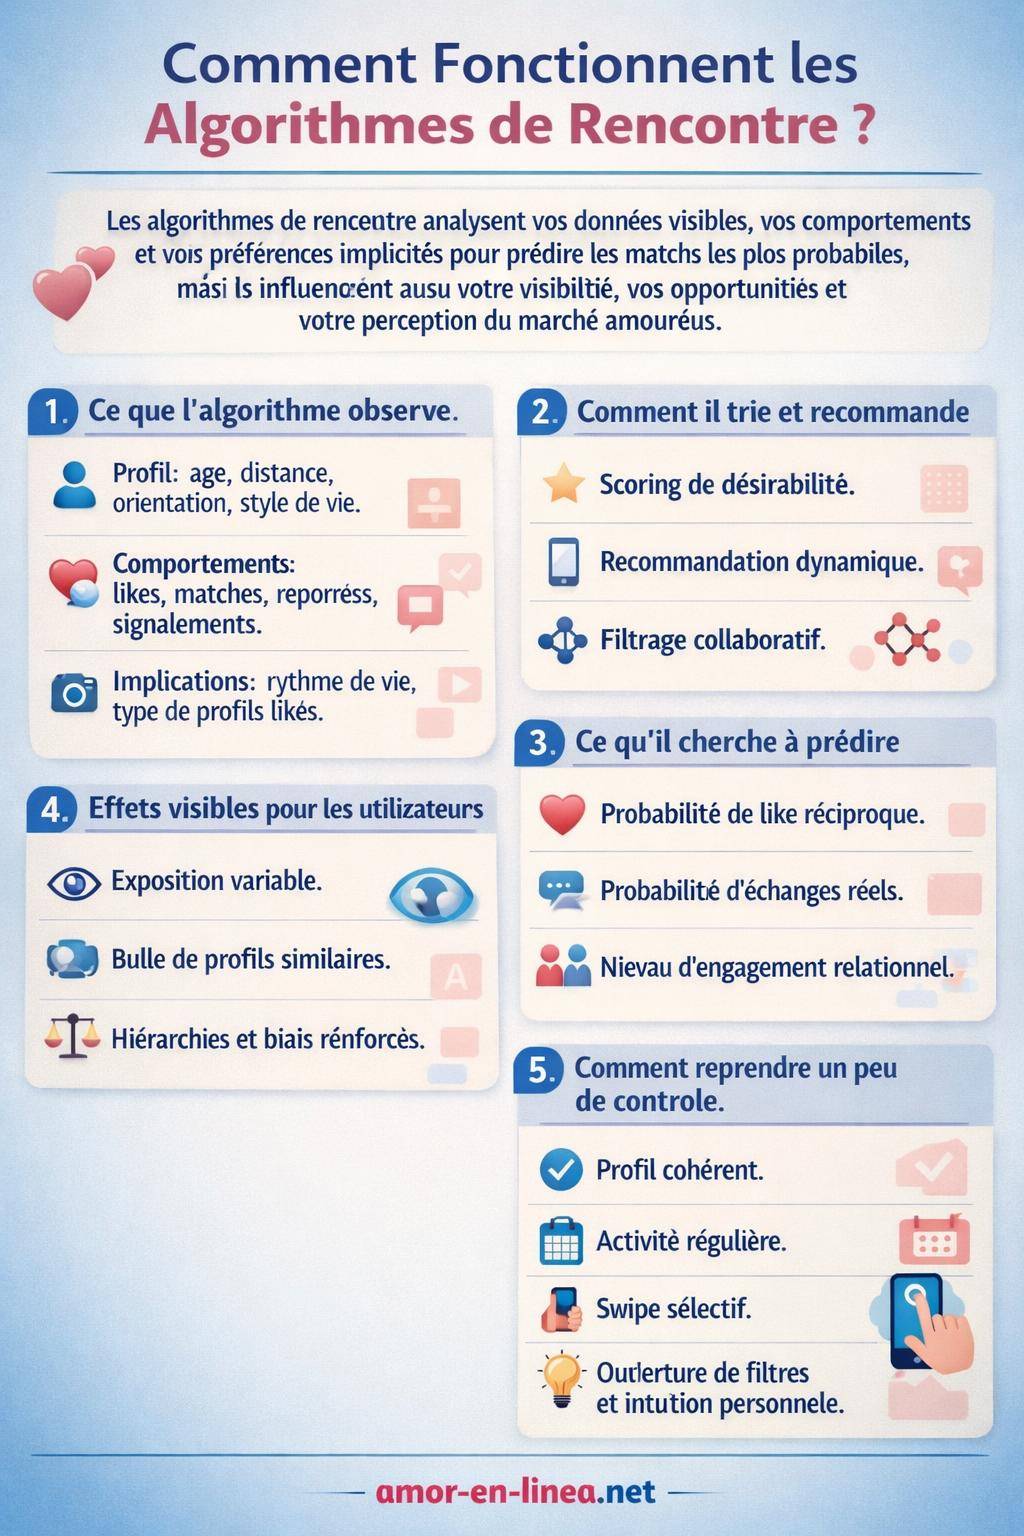
Un algorithme de rencontre en ligne correspond à un ensemble de règles mathématiques et de modèles statistiques qui organisent l’ordre d’affichage des profils. Il ne se contente pas de montrer des utilisateurs au hasard. Il analyse un grand volume de données pour proposer des profils jugés compatibles avec vos goûts, vos habitudes et votre historique de swipe.
Les plateformes de dating s’appuient sur ces algorithmes pour retenir l’attention, augmenter le taux de match et favoriser les conversations. Le but affiché consiste souvent à maximiser les rencontres pertinentes. Le but réel combine aussi des enjeux de temps passé sur l’application, d’abonnements payants et de valorisation des données.
L’algorithme observe tout : heure de connexion, vitesse de swipe, taux de réponses aux messages, fréquence de matchs, signaux de rejet. Chacun de ces signaux nourrit un score de compatibilité, plus ou moins transparent selon les plateformes. Ce fonctionnement influence directement qui vous voyez, mais aussi qui vous voit.
Les données utilisées par les algorithmes de dating : ce qui est vraiment pris en compte
Les algorithmes se nourrissent d’un large volume de données comportementales et déclaratives. Une partie provient de ce que vous renseignez directement, une autre de ce que l’application enregistre pendant votre utilisation quotidienne, parfois de manière très fine.
On peut distinguer plusieurs grandes familles de données que les algorithmes exploitent pour construire des modèles de compatibilité.
Données de profil : identité, style de vie et préférences
Les informations déclarées dans votre profil servent de socle de base pour le tri initial. Ces éléments restent visibles et relativement faciles à maîtriser. Ils orientent les premiers filtres appliqués par l’algorithme.
Parmi les données de profil les plus utilisées, on retrouve :
- Localisation géographique : ville, distance maximale acceptée, mobilité éventuelle.
- Âge et tranche d’âge recherchée : critère dur, souvent non négociable.
- Genre et orientation : paramètre central pour le matching de base.
- Informations de style de vie : tabac, alcool, sport, régime alimentaire, enfants, croyances.
- Objectif affiché : relation longue, rencontre ponctuelle, amitié, expérimentation.
- Photo de profil : type de cadrage, style vestimentaire, environnement, présence d’amis ou non.
Ces éléments influencent à la fois le filtrage automatique et les réactions des autres utilisateurs. Un profil bien rempli tend à générer plus d’interactions, ce qui renforce le signal envoyé à l’algorithme sur votre « intérêt potentiel ».
Comportements en temps réel : swipes, likes et réponses
Les données comportementales constituent le cœur du moteur de recommandation. L’algorithme observe vos actions, en tire des tendances, puis ajuste la sélection de profils proposée.
Parmi ces signaux, on trouve notamment :
- Fréquence des connexions : utilisateur très présent, occasionnel, nocturne, du matin.
- Taux de like : sélectivité, tendance à liker rarement ou très souvent.
- Taux de match : proportion de likes réciproques vs likes unilatéraux.
- Qualité des conversations : longueur des échanges, poursuite ou abandon rapide.
- Signaux négatifs : blocages, signalements, unmatchs précoces.
Un utilisateur très actif, avec un taux de réponse élevé, est souvent mis en avant auprès d’autres profils jugés réactifs. À l’inverse, un profil qui laisse systématiquement les conversations sans suite envoie un signal de moindre engagement relationnel.
Données implicites : langage, style d’écriture et préférences cachées
Au-delà des données visibles, certains algorithmes suivent des signaux plus subtils. Les modèles de machine learning analysent par exemple le type de profil que vous likez, indépendamment de ce que vous dites préférer dans vos filtres.
Plusieurs dimensions entrent en jeu :
- Type de photos likées : selfies, photos de voyage, photo de groupe, style plus posé ou spontané.
- Niveau de langage dans la bio : registre familier, soutenu, humour, références culturelles.
- Longueur des messages : phrases courtes, pavés argumentés, usage de gifs et emojis.
- Heure d’activité : utilisateur plutôt nocturne, connectés aux heures de pause, connecté en continu.
Ces signaux, combinés, construisent un profil comportemental précis. Le but consiste à rapprocher des utilisateurs qui partagent des modes de communication et des rythmes de vie compatibles, même si ces dimensions ne sont jamais formulées explicitement.
Les grands types d’algorithmes de matching en ligne
Toutes les plateformes n’utilisent pas le même type d’algorithme. Plusieurs approches coexistent, souvent mélangées. Connaître ces grandes familles permet de mieux interpréter les réactions de l’application à vos actions.
On peut mettre en avant trois grandes logiques de matching : le scoring, les modèles de recommandation inspirés des réseaux sociaux ou des plateformes de streaming, et le filtrage collaboratif.
Algorithmes de scoring : notation de désirabilité et compatibilité
Certains services reposent sur un système de score, visible ou non. Chaque profil obtient une note, réévaluée en permanence, liée à son attractivité et à son niveau d’engagement. Ce score guide ensuite l’ordre d’affichage des profils dans votre file de suggestions.
Rencontres en ligneVrai amour en ligne : le guide pour construire une relation équilibrée et durableLes critères fréquents de ces systèmes de scoring :
- Nombre de likes reçus sur une période donnée.
- Ratio likes / vues : proportion de personnes qui like votre profil après l’avoir vu.
- Taux de réponse aux messages et maintien des conversations.
- Signalements ou blocages, qui réduisent mécaniquement le score.
Ce type de logique introduit une hiérarchie implicite : certains profils circulent davantage et obtiennent plus d’exposition, tandis que d’autres restent beaucoup plus discrets, voire invisibles pour une partie des membres.
Algorithmes de recommandation : comme un fil d’actualité amoureux
D’autres plateformes adoptent une logique inspirée des réseaux sociaux. L’algorithme agit comme un fil d’actualité personnalisé, qui met en avant les profils jugés « pertinents » pour vous, sur la base de l’historique de vos interactions.
Les caractéristiques de cette approche :
- Personnalisation progressive : plus vous utilisez l’application, plus les suggestions s’ajustent.
- Réaction en temps réel : un changement de comportement influence rapidement les profils proposés.
- Effet de bulle : l’algorithme tend à renforcer vos préférences habituelles et à vous montrer des profils similaires à ceux que vous avez déjà likés.
Cette logique rapproche fortement les applis de dating d’autres usages numériques. L’intimité numérique devient un univers continu, comme expliqué dans l’article sur l’expérience de l’intimité numérique, où les interactions affectives se mêlent aux algorithmes de recommandation.
Filtrage collaboratif : ceux qui aiment les mêmes profils que vous
Le filtrage collaboratif s’inspire des moteurs de recommandation utilisés dans le e-commerce ou les plateformes de vidéo. L’idée : rapprocher des utilisateurs en fonction des profils qu’ils likent en commun, même s’ils ne se connaissent pas.
Dans ce modèle, l’algorithme se pose des questions du type :
- « Les personnes qui likent ce profil aiment aussi ces autres profils. »
- « Les utilisateurs qui swipent à droite sur les mêmes personnes que vous correspondent à votre style. »
Cette approche permet de faire émerger des correspondances moins évidentes, en dépassant les seuls critères visibles. Elle renforce aussi la logique de groupe implicite : sans le savoir, vous êtes classé dans un ensemble d’utilisateurs à comportements jugés similaires.
Comment les algorithmes évaluent la compatibilité entre deux profils
La compatibilité ne se limite pas à « mêmes centres d’intérêt ». L’algorithme évalue surtout la probabilité que deux personnes se like mutuellement, puis échangent des messages. Autrement dit, il cherche à prédire l’engagement relationnel plutôt que l’affinité philosophique.
Pour structurer cette évaluation, plusieurs dimensions se combinent en permanence.
Affinité déclarative : ce que vous dites chercher
L’algorithme commence par respecter vos filtres déclarés. Si vous limitez la distance, l’âge ou l’orientation, ces paramètres cadrent mécaniquement votre univers de rencontre possible. Les préférences affichées servent de garde-fou.
Ensuite, l’algorithme affine :
- Concordance des objectifs relationnels (sérieux, léger, exploration).
- Présence ou non d’enfants, désir d’en avoir.
- Pratiques de vie quotidienne (tabac, rythme de sortie).
- Valeurs affichées dans la bio (engagement écologique, politique, religieux).
Cette couche déclarative reste souvent plus simple que la réalité des comportements. De nombreux utilisateurs déclarent chercher une chose, tout en se comportant parfois à l’opposé. L’algorithme finit par arbitrer entre ce qui est dit et ce qui est fait.
Compatibilité comportementale : ce que vous faites réellement
C’est là que l’algorithme devient plus fin. Il se base sur la logique suivante : des utilisateurs qui interagissent de la même manière, aux mêmes moments, avec des types de profils comparables, présentent une probabilité plus forte de se comprendre au quotidien.
On retrouve par exemple :
- Rythme de connexion similaire (plutôt soir, week-end, journée).
- Longueur moyenne des conversations.
- Temps de réponse aux messages.
- Réaction aux relances (acceptation, agacement, silence).
Deux personnes très actives, qui aiment les échanges rapides et denses, sont plus souvent mises en relation qu’un utilisateur très bavard avec un profil quasi absent. La compatibilité se mesure aussi dans la gestion du temps et de l’énergie relationnelle.
Attractivité croisée : probabilité de match réciproque
Un autre axe tient une place centrale : la probabilité que deux utilisateurs se likent mutuellement. L’algorithme cherche à éviter les « impasses », c’est-à-dire les likes unilatéraux qui ne débouchent sur rien.
Cette dimension s’appuie notamment sur :
- Le score de désirabilité estimé de chaque profil.
- Le type de profils qui like généralement chacun d’eux.
- Les historiques de matches réels sur des profils similaires.
Si un utilisateur reçoit beaucoup de likes mais en donne peu, l’algorithme aura tendance à montrer ce profil avec parcimonie à ceux qui manifestent un taux de match plus bas, pour limiter les déceptions en chaîne.
Impact concret des algorithmes sur votre expérience de rencontre
Les décisions prises par les algorithmes structurent fortement votre perception du marché amoureux numérique. Certains ressentent une abondance de choix, d’autres une impression de rareté extrême, alors qu’ils se trouvent sur la même plateforme.
Plusieurs effets significatifs en découlent : hiérarchie implicite, atomisation des publics, renforcement de certains biais et frustration difficile à interpréter.
Effet de vitrine : qui voit qui, et dans quel ordre
L’algorithme contrôle votre « vitrine » : il choisit à qui montrer votre profil, dans quel contexte et à quel moment. Deux utilisateurs présents dans la même ville, au même instant, ne reçoivent pas le même volume d’exposition.
On observe souvent :
- Une mise en avant des profils nouveaux, pour tester rapidement leur capacité de match.
- Un boost momentané des profils récemment réactivés.
- Une mise sous cloche des profils très peu actifs.
Ce fonctionnement influence directement votre ressenti. Un nouvel inscrit qui reçoit beaucoup de matches en quelques heures aura l’impression d’une abondance. Un utilisateur plus ancien, moins mis en avant, verra des profils moins réactifs et ressentira davantage de lassitude.
Biais et effets de bulle : similarité et répétition
Les algorithmes tendent à renforcer certaines tendances sociales, parfois sans l’assumer clairement. En privilégiant les profils qui « marchent » bien, ils accentuent la visibilité de certains types physiques, styles de vie ou codes culturels au détriment d’autres.
Conséquences fréquentes :
- Homogénéisation des profils visibles sur une même zone.
- Réduction de la diversité des rencontres proposées.
- Renforcement de stéréotypes déjà présents hors ligne.
Ce type d’effet alimente le sentiment de répétition, voire de lassitude. Certains utilisateurs ont l’impression de croiser en boucle les mêmes profils, alors que d’autres restent invisibles, enfermés dans une autre « bulle » algorithmique.
« Je vois toujours le même type de personnes, comme si l’application avait décidé pour moi de ce qui me correspond, alors que je serais curieux de rencontrer d’autres profils. » — Témoignage d’utilisateur
Peut-on vraiment optimiser son profil pour l’algorithme ?
Optimiser son profil ne se réduit pas à « mettre de belles photos ». L’objectif consiste à rendre votre présence lisible, cohérente et engagée, de manière à envoyer des signaux clairs à la fois aux autres utilisateurs et à l’algorithme.
Cette démarche demande de travailler à la fois le contenu visible du profil et votre manière d’interagir sur l’application au quotidien.
Structurer un profil lisible pour l’algorithme et pour les autres
Un profil bien construit augmente la probabilité de match et rend votre comportement plus interprétable pour l’algorithme. Plusieurs leviers se combinent.
Points clés à travailler :
- Photos variées : portrait clair, plan en pied, activité ou passion, moment social.
- Bio concise mais précise : quelques éléments de personnalité, centres d’intérêt concrets, ton assumé.
- Objectif relationnel explicite : relation stable, rencontre légère, exploration, etc.
- Cohérence globale : éviter le décalage entre photos, bio et comportement en conversation.
Un profil cohérent aide l’algorithme à vous classer dans des segments compréhensibles. Il facilite aussi la prise de décision pour les autres utilisateurs, ce qui se traduit souvent par un meilleur taux de match.
Adopter un comportement lisible : ni passif, ni compulsif
La manière dont vous swippez et discutez influence fortement l’image que l’algorithme se fait de vous. Un utilisateur qui like tout, ou presque, n’envoie pas le même signal qu’une personne plus sélective et engagée dans les échanges.
Quelques repères :
- Éviter le swipe massif sans lecture des profils.
- Rester régulier : quelques connexions fréquentes valent mieux qu’une énorme session rare.
- Répondre aux conversations qui vous intéressent réellement.
- Fermer proprement un échange qui ne vous convient plus, plutôt que disparaître brutalement.
Ce type de comportement contribue à construire un signal d’utilisateur fiable, ce qui renforce la confiance de l’algorithme dans votre capacité à générer des interactions de qualité.
Jouer sur le timing et la fréquence de connexion
Le moment où vous ouvrez l’application influence aussi la visibilité de votre profil. Lorsqu’un utilisateur est en ligne, l’algorithme peut le pousser davantage auprès d’autres profils connectés au même moment, afin de favoriser des échanges rapides.
Stratégies simples :
- Se connecter quand votre ville est la plus active (soirées, week-ends).
- Éviter les longues périodes de silence total, qui réduisent le signal d’activité.
- Ne pas multiplier les connexions très courtes, qui donnent une impression de survol permanent.
Un rythme stable et prévisible facilite aussi l’ajustement des suggestions. L’algorithme comprend mieux quels profils vous conviennent réellement sur la durée.
Différences d’algorithmes selon les types de plateformes
Toutes les applications de rencontre n’ont pas la même stratégie. Certaines visent l’instantanéité et la quantité, d’autres misent sur la compatibilité à moyen terme. Les algorithmes reflètent ces orientations commerciales et culturelles.
Comparer quelques grandes familles de plateformes permet de mieux situer votre expérience.
Applications orientées swipe rapide
Les services de type « swipe » privilégient le volume et la vitesse. L’algorithme cherche à générer un flux continu de profils faciles à parcourir. Le scoring de désirabilité occupe souvent une place centrale, avec des mises en avant ponctuelles de profils jugés « performants ».
Les caractéristiques fréquentes :
- Fil de profils très dense, rafraîchi rapidement.
- Score implicite associé à chaque utilisateur.
- Visibilité influencée par l’achat de boosts ou d’options premium.
Dans ce type d’environnement, des conseils spécifiques sur la gestion du swipe, comme ceux présentés dans ce guide dédié au matching sur Tinder, aident à reprendre un peu le contrôle.
Sites plus relationnels ou affinitaires
Les plateformes orientées compatibilité longue durée accordent plus de poids aux questionnaires et aux tests de personnalité. L’algorithme croise un volume important de données déclaratives pour produire des suggestions jugées cohérentes avec vos valeurs et votre mode de vie.
On observe souvent :
- Questionnaires détaillés à l’inscription.
- Mise en avant de profils limités chaque jour, plutôt que flux infini.
- Algorithmes plus transparents sur les critères déclarés de compatibilité.
Ce fonctionnement réduit le sentiment de zapping permanent. Les algorithmes y agissent davantage comme des intermédiaires que comme des générateurs d’abondance.
Plateformes hybrides et expérimentation algorithmique
Entre ces deux extrêmes, un large éventail de services expérimente des formats hybrides. Certains mélangent swipe rapide et tests de compatibilité, d’autres introduisent des filtres plus fins autour de la sexualité, des valeurs ou du style de vie.
Rencontres en ligneAmitié en ligne : comment rencontrer des gens qui partagent vos passionsCette diversité se traduit par :
- Tests ponctuels de nouvelles fonctionnalités.
- Algorithmes en évolution constante, ajustés selon les retours et les statistiques.
- Possibles modifications brusques de visibilité pour certains profils.
Les utilisateurs ressentent parfois ces changements lorsque leur volume de matchs varie soudainement, sans modification de comportement de leur part.
Les aspects cachés : opacité, biais et enjeux éthiques
Les plateformes communiquent rarement en détail sur leurs algorithmes. L’opacité tient autant à la complexité technique qu’aux enjeux commerciaux. Cette absence de transparence soulève des questions sur la façon dont les rencontres sont réellement structurées.
Plusieurs points méritent une attention particulière : traitement des données, biais potentiels, priorisation des utilisateurs payants et gestion des signalements.
Opacité des critères et difficulté à interpréter l’échec
Un utilisateur qui reçoit peu de matchs ignore souvent si la cause tient à son profil, à son comportement, à la zone géographique… ou à un changement d’algorithme. Cette incertitude nourrit parfois un sentiment d’échec personnel alors que la logique technique joue un rôle important.
Les plateformes se contentent souvent de messages génériques. Les détails finement techniques restent protégés, présentés comme secret industriel.
« Nous utilisons un algorithme propriétaire pour vous proposer des profils susceptibles de vous intéresser. » — Extrait type des conditions d’utilisation des applications de rencontre
Priorisation des utilisateurs payants
La plupart des services adoptent un modèle freemium. L’algorithme intègre alors un paramètre crucial : la monétisation. Les profils abonnés ou ayant acheté des boosts reçoivent généralement un supplément de visibilité, sans que cette priorité soit toujours mise en avant de manière très claire.
Effets possibles :
- Ressenti de stagnation chez les utilisateurs gratuits.
- Injonction implicite à payer pour « débloquer » la situation.
- Confusion entre attractivité réelle et simple exposition accrue.
Cette dimension commerciale renforce le besoin de garder un regard critique sur l’expérience vécue, comme l’illustre bien l’analyse de la face cachée de Tinder et des mécaniques économiques qui structurent le marché des rencontres en ligne.
Biais algorithmiques et reproduction des inégalités
Les algorithmes apprennent à partir des comportements réels des utilisateurs. Or ces comportements portent déjà des biais sociaux préexistants : préférences liées à l’âge, au genre, à l’origine, au physique, à la situation socio-économique.
Résultat :
- Certains profils reçoivent une exposition très élevée.
- D’autres se trouvent systématiquement relégués à l’arrière-plan.
- Les préférences individuelles se transforment en règles statistiques qui orientent, parfois fortement, la dynamique globale.
Ces effets restent rarement pris en charge de manière explicite. La responsabilité se dilue entre « choix individuels » et « simple reflet » des comportements globaux, alors que les décisions d’algorithme amplifient ou réduisent certains biais.
Utiliser les algorithmes sans subir : posture, limites et attentes réalistes
Les algorithmes structurent le terrain de jeu, mais ne décident pas de tout. Une posture lucide permet de profiter des atouts du matching automatisé sans se laisser enfermer dans une logique de performance ou de collection de profils.
La rencontre en ligne reste un outil, pas un jugement définitif de votre valeur relationnelle.
Gérer ses attentes face aux métriques visibles
Nombre de matchs, volume de messages, durée des conversations : ces métriques influencent fort l’estime de soi lorsqu’on les observe sans recul. Elles reflètent souvent davantage un contexte technique et social qu’une vérité sur votre capacité à rencontrer quelqu’un.
Quelques repères pour garder une distance saine :
- Ne pas se définir par un nombre de matchs.
- Se rappeler que les algorithmes ajustent constamment la visibilité.
- Se concentrer sur la qualité de quelques échanges plutôt que sur la quantité de swipes.
Cette posture aide à sortir d’une logique de compétition silencieuse, très présente dans les environnements régis par les algorithmes.
Articuler algorithme et intuition personnelle
Les suggestions de l’algorithme offrent un point de départ, pas une contrainte absolue. Laisser une place à l’intuition, à la curiosité et à l’imprévu permet d’équilibrer la logique automatisée et la dimension humaine des rencontres.
Stratégies concrètes :
- Ouvrir un peu ses filtres d’âge ou de distance, au moins ponctuellement.
- Liker parfois un profil qui sort légèrement de votre « type » habituel, si un détail vous attire.
- Accorder sa chance à des bios moins spectralement proches de vos propres codes, mais sincères.
Cette marge de manœuvre contribue à réintroduire une forme d’aléatoire contrôlé dans un environnement largement structuré par le calcul.
Composer avec la dimension émotionnelle des rencontres algorithmiques
Les algorithmes ne gèrent pas les émotions générées par leur fonctionnement : espoir, excitation, frustration, lassitude. Ces états varient selon les périodes et les expériences. Les prendre en compte fait partie intégrante d’une utilisation durable des applications.
Repères simples :
- Interrompre une session de swipe lorsqu’elle devient mécanique ou agacée.
- Prendre des pauses volontaires pour éviter la saturation.
- Revoir son profil et ses habitudes de conversation lorsqu’un malaise persiste.
Cette attention à soi permet de rester sujet de l’expérience, plutôt qu’objet d’un flux algorithmique qui enchaîne les profils sans prendre en compte votre état intérieur.
Julie Marceau
Mardi, 18 h 30. En face de moi, un homme de 41 ans qui n'a abordé personne depuis 2019. On répète la première phrase jusqu'à ce qu'elle tienne en huit mots. On chronomètre le silence qu'il n'ose pas laisser. On décide de l'heure à laquelle il…
